Combien de fois ai-je vu des développeurs monter une usine à gaz pour un projet web qui dépasse à peine dix requêtes par seconde ? On loue un droplet chez DigitalOcean, on colle un conteneur PostgreSQL, on s'arrache les cheveux sur les réglages de pgbouncer, et on finit par payer 80 euros par mois pour synchroniser des données que mon smartphone stockerait sans chauffer. C'est absurde. Cette manie d'ériger PostgreSQL ou MySQL en standards incontournables dès le premier commit m'exaspère.
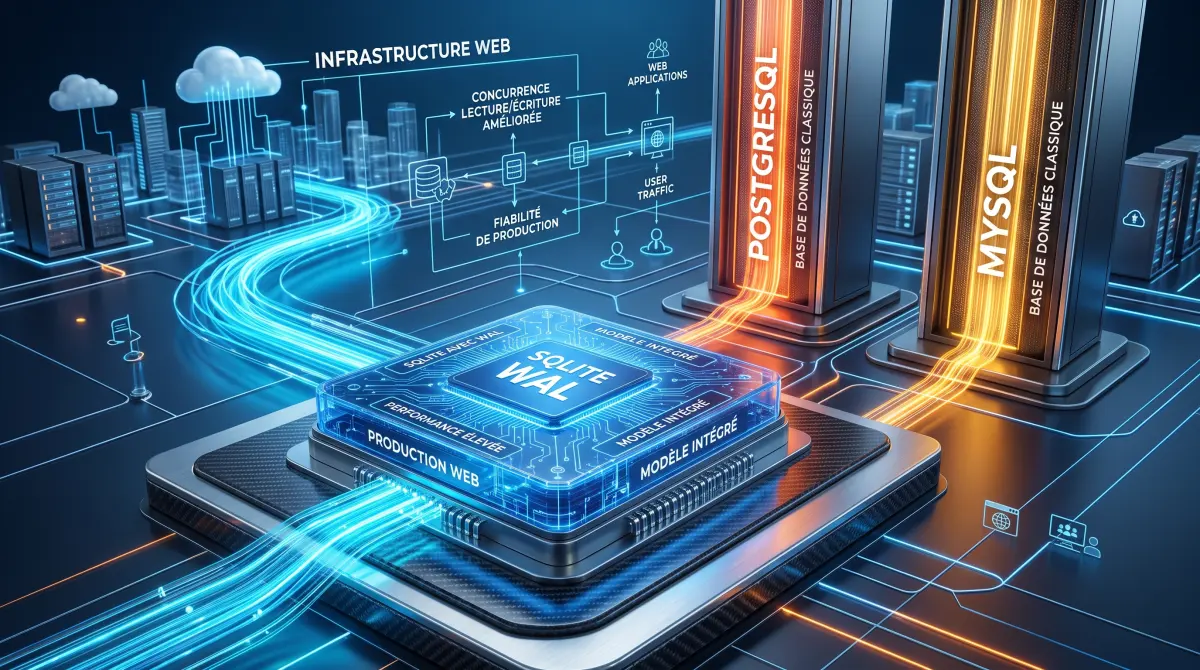
Pourtant, SQLite sommeille au fond de presque tous les frameworks modernes. Mais voilà : pour la majorité des ingénieurs élevés aux ORM boursouflés, ce moteur reste un outil de bricoleur ou un simple fichier de test local. C'est faux. Avec une architecture taillée pour la production et l'activation du mode sqlite wal (Write-Ahead Logging), ce moteur embarqué pulvérise régulièrement les bases de données client-serveur sur les applications monolithiques. Pourquoi ? Parce qu'on supprime purement et simplement la pile réseau.
Le mécanisme du mode wal : adieu le rollback journal
Par défaut, SQLite fonctionne à l'ancienne via ce qu'on nomme le rollback journal. Dans ce schéma historique, chaque écriture bloque impitoyablement les lecteurs, et chaque lecture bloque les écrivains. Sur le web, c'est l'asphyxie garantie au moindre pic de trafic. Vous obtenez cette erreur redoutée : SQLITE_BUSY. La base se fige, la file d'attente explose, vos workers PHP, Node ou Go partent en timeout.
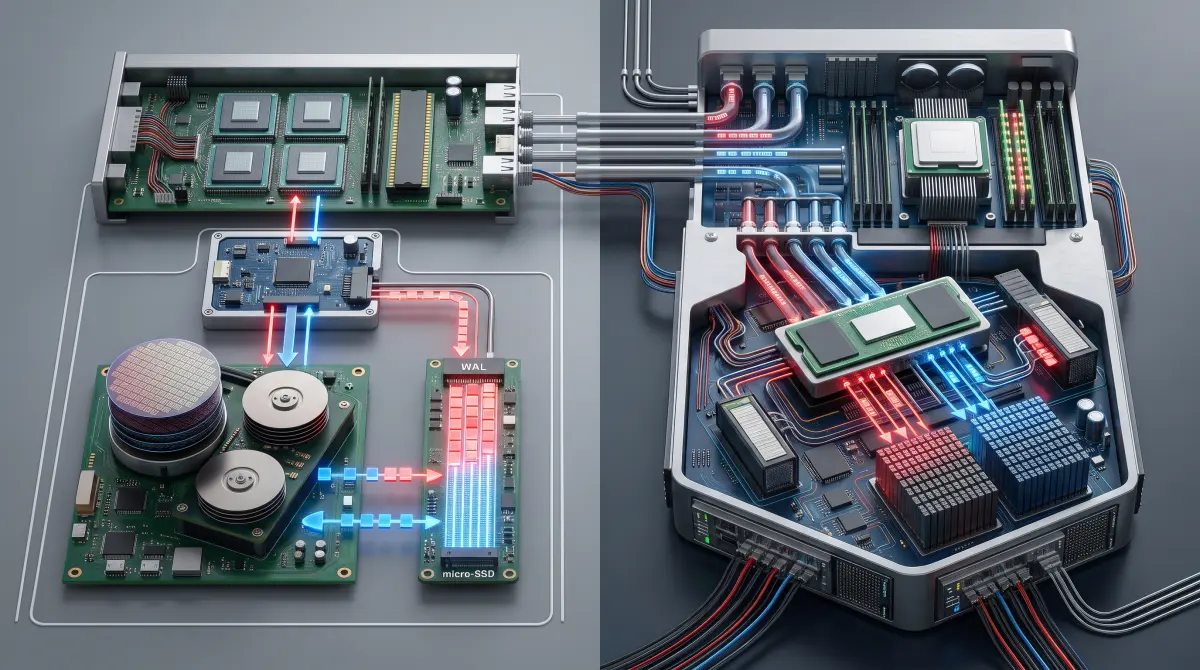
Le mode WAL renverse complètement cette logique en modifiant la manière dont les transactions touchent le support de stockage physique. Dès qu'on l'active, SQLite cesse d'écrire directement dans le fichier principal .db. Toutes les modifications (insertions, suppressions, mises à jour) atterrissent séquentiellement dans un fichier annexe nommé .db-wal. En parallèle, un fichier d'index partagé en mémoire vive, le .db-shm, garde trace des emplacements de ces pages modifiées.
Le gain en concurrence est immédiat : les lecteurs interrogent tranquillement l'état de la base sans jamais verrouiller l'écrivain, qui empile ses modifications à la fin du fichier WAL sans écraser les blocs en cours de lecture. Mieux encore : comme les écritures deviennent séquentielles (append-only), le disque NVMe n'a plus à faire des allers-retours désordonnés pour mettre à jour l'arbre B-Tree principal. Les I/O s'effondrent, les débits grimpent. Vous pouvez consulter les détails de bas niveau directement sur la documentation officielle SQLite WAL.
Configuration critique : les pragmas indispensables en prod
Ne vous avisez pas de basculer SQLite en prod sans toucher à sa configuration. Par défaut, le moteur est paramétré de façon ultra-conservatrice pour ne jamais corrompre un fichier, même si vous arrachez la prise de courant d'un microcontrôleur en plein flash. Sur un serveur Linux fiable abrité dans un datacenter avec onduleur, ces garde-fous par défaut détruisent les performances.
Voici les pragmas que j'injecte systématiquement à l'ouverture de chaque connexion dans mes services :
PRAGMA journal_mode = WAL;
PRAGMA busy_timeout = 5000;
PRAGMA synchronous = NORMAL;
PRAGMA cache_size = -64000;
PRAGMA foreign_keys = ON;
PRAGMA temp_store = MEMORY;
Détaillons ce qui compte vraiment. Le PRAGMA synchronous = NORMAL; est la clé de voûte. En mode WAL, la valeur NORMAL ne force l'appel système fsync() que lors des points de contrôle (les fameux checkpoints), plutôt qu'à chaque micro-transaction d'écriture. Le risque de corruption lors d'un crash de l'OS est infinitésimal, et le bond de performance en écriture atteint un facteur 10 voire 20 sur mes SSD PCIe 4.0.
Autre paramètre capital : le busy_timeout = 5000. Par défaut, SQLite renvoie immédiatement une erreur s'il tente d'écrire alors qu'une autre écriture est en cours. En lui donnant 5 secondes de tolérance, le thread attend patiemment que la milliseconde d'écriture précédente s'achève. Fini les exceptions arbitraires dans votre code applicatif. Enfin, le cache_size = -64000 alloue 64 Mo de mémoire vive au cache des pages par processus, maintenant les structures fréquemment lues directement en RAM.
Banc d'essai et latence : l'élimination pure du saut réseau
Prenons un cas classique : vous hébergez votre application Next.js, Django ou Go sur un serveur, et votre instance PostgreSQL ou MySQL sur un serveur managé dédié. Entre les deux, même au sein du même réseau privé virtuel (VPC) chez AWS ou Hetzner, vous subissez la latence TCP. Comptez entre 0,5 et 1,5 milliseconde par aller-retour réseau. Si votre page web exécute 15 requêtes SQL pour assembler son affichage, vous ajoutez bêtement 15 millisecondes de pure latence d'infrastructure, avant même d'avoir calculé le moindre résultat.
Avec SQLite embarqué directement dans l'espace mémoire de votre processus via des liaisons C/Rust, le temps d'accès tombe à moins de 20 microsecondes (0,02 ms). La requête n'est pas sérialisée en JSON ou dans un protocole binaire filaire : c'est un simple appel de fonction (FFI) lisant un bloc mémoire mappé (mmap). Vos endpoints répondent en 2 millisecondes là où une architecture distribuée stagne à 40 millisecondes.
| Critère technique | SQLite (Mode WAL) | PostgreSQL 16 | MySQL 8.4 (InnoDB) |
|---|---|---|---|
| Architecture d'accès | In-process (mémoire partagée, pas d'IPC/TCP) | Client-Serveur (sockets TCP/Unix) | Client-Serveur (sockets TCP/Unix) |
| Latence médiane en lecture | < 0,05 ms | 0,8 à 2,5 ms (sur réseau local) | 0,8 à 2,8 ms (sur réseau local) |
| Concurrence en écriture | 1 seul écrivain exclusif à l'instant T | Multi-écrivains (verrous par ligne MVCC) | Multi-écrivains (verrous par ligne MVCC) |
| Empreinte RAM minimale | < 10 Mo par instance | 128 Mo à 1 Go (shared buffers) | 256 Mo à 1 Go (innodb_buffer_pool) |
| Opérations d'administration | Zéro daemon, un fichier binaire unique | Maintenance VACUUM, tuning workers, TLS | Maintenance purge threads, binlogs, TLS |
| Sauvegarde à chaud | Litestream, VACUUM INTO | pg_dump, WAL archiving, Barman | mysqldump, Percona XtraBackup |
Pour approfondir la gestion native des journaux de transactions chez son principal rival serveur, jetez un œil à la façon dont PostgreSQL implémente son propre WAL. Le principe théorique de l'append-only est identique, mais l'empilement réseau et la gestion des processus concurrents transforment drastiquement les coûts en mémoire et en complexité d'exploitation.
Le mur de la concurrence : quand sqlite rend les armes
Ne tombons pas dans le piège de la foi aveugle : SQLite n'est pas une balle en argent. Le mode WAL apporte la lecture non bloquante concurrente illimitée, mais il ne change rien à une loi physique fondamentale de SQLite : il ne peut y avoir qu'un seul écrivain à la fois sur l'intégralité du fichier de base de données.
Tant que vos écritures durent une fraction de milliseconde, ce goulet d'étranglement est transparent. Un SQLite bien configuré sur du matériel moderne encaisse facilement entre 2 000 et 4 000 transactions d'écriture par seconde. Avez-vous 3 000 personnes qui cliquent sur un bouton de commande ou qui modifient leur mot de passe chaque seconde sur votre SaaS ? Soyons clairs : non. 98 % des sites web affichent un ratio lecture/écriture d'au moins 9 pour 1.
Le piège se referme si vous commencez à encapsuler des traitements lourds dans vos transactions. Si vous ouvrez une transaction SQL, que vous attendez un appel à l'API Stripe en HTTP, puis que vous mettez à jour votre table, votre fichier SQLite est verrouillé pendant 800 millisecondes. Pendant ce temps, toutes les autres écritures s'accumulent, atteignent le busy_timeout et votre serveur s'écroule. Avec PostgreSQL ou MySQL, le verrouillage par ligne (Row-Level Locking) via MVCC évite ce désastre car deux requêtes modifiant deux lignes différentes n'entrent jamais en conflit.
Stratégie de maintenance : dompter les checkpoints
Si vous laissez le mode WAL tourner sans surveillance en production, vous risquez une surprise désagréable : le fichier .db-wal peut grossir indéfiniment jusqu'à saturer votre disque dur. Par défaut, SQLite déclenche une opération automatique de réintégration (le checkpoint) dès que le fichier WAL atteint 1 000 pages (soit environ 4 Mo).
Le problème survient en cas de trafic de lecture ininterrompu. Si au moins un lecteur conserve une transaction ouverte sur une version ancienne de la base, le mécanisme de checkpoint ne peut pas réécrire les pages du WAL vers le fichier .db principal. Les modifications s'accumulent, le fichier temporaire enfle, et pire encore : les performances des lecteurs se dégradent car ils doivent scanner un fichier WAL gigantesque pour trouver les pages récentes.
Pour garder le contrôle en production, je désactive le checkpoint passif aléatoire et je configure un worker d'arrière-plan ou un cron dédié qui exécute périodiquement une commande explicite :
PRAGMA wal_checkpoint(TRUNCATE);Cette instruction force l'écriture de toutes les transactions du journal WAL vers le fichier principal, attend si nécessaire un instant de répit, puis remet à zéro la taille du fichier physique sur le disque. C'est propre, prévisible et parfaitement mesurable via vos sondes Prometheus ou vos métriques système habituelles.
Faut-il migrer votre architecture dès demain ?
Je ne vous conseille pas de réécrire vos applications d'entreprise existantes connectées à des clusters MySQL ou PostgreSQL qui fonctionnent déjà sans accroc. Le coût humain dépasserait largement les bénéfices d'infrastructure.
Posez-vous plutôt la question pour votre prochain microservice, votre dashboard interne ou votre nouveau produit SaaS. Pourquoi s'encombrer d'un réseau complexe, d'un ORM lourd pour gérer les pools de connexions et d'une facture cloud délirante quand un simple fichier local couplé au mode WAL surpasse n'importe quel serveur distant en temps de réponse ? Rangez l'ego d'ingénieur au placard, activez les bons pragmas, et laissez la puissance brute du matériel moderne faire le travail.