Quand je lance Cyberpunk 2077 en mode Ray Tracing Overdrive sur ma machine de test équipée d'une RTX 4090, le GPU avale plus de 400 watts pour projeter des millions de rayons lumineux par seconde. Les néons de Night City se reflètent sur le bitume mouillé avec une précision folle. Mais derrière cette vitrine technologique que les services marketing adorent nous vendre à coup de graphiques trompeurs, il y a un mur arithmétique colossal.
Sans une structure de données précise — le BVH pour Bounding Volume Hierarchy —, nos cartes graphiques modernes ne sortiraient même pas trois images par seconde en 1080p. Pas dix. Pas cinq. Moins d'une frame par seconde. C'est mathématique. Analysons ensemble les entrailles de cette machinerie algorithmique.
Le gouffre mathématique : pourquoi tester chaque triangle tuerait vos GPU
Posons le problème sur la table sans détour. Une scène de jeu vidéo moderne en 2026 affiche facilement entre 20 et 50 millions de polygones par image, surtout depuis la démocratisation des géométries denses sous Unreal Engine 5. Si vous jouez en 4K native (3840 × 2160 pixels), votre écran compte environ 8,3 millions de points d'affichage.
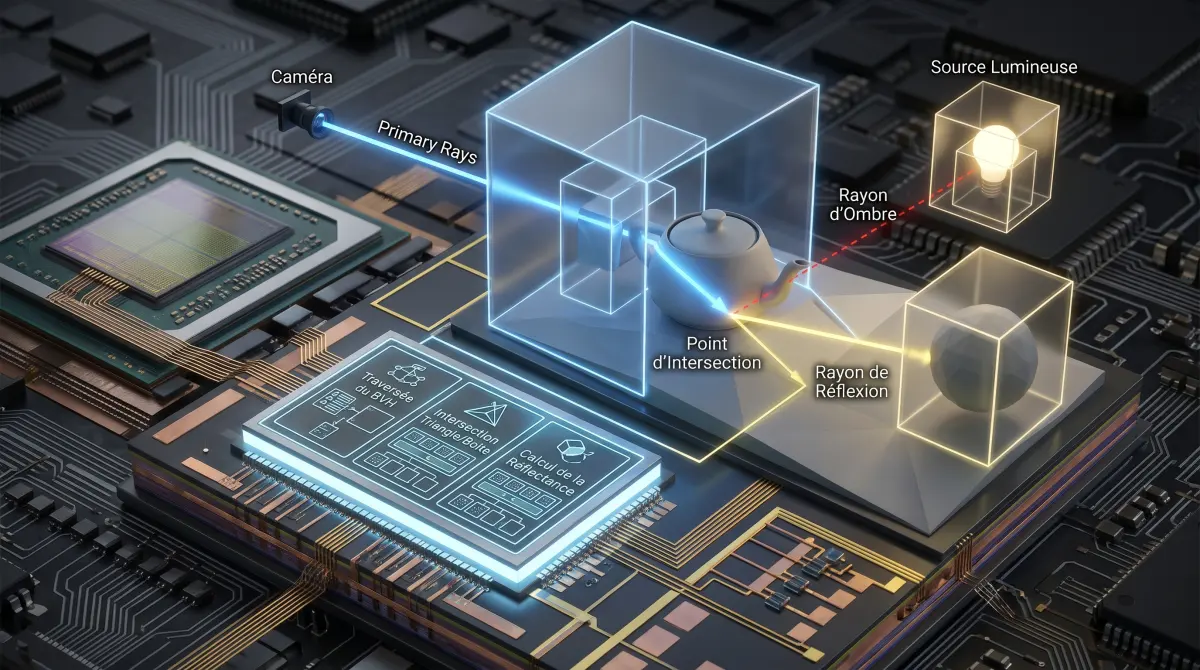
Pour calculer la lumière en ray tracing direct, vous devez tirer au minimum un rayon primaire par pixel. Dès qu'un rayon heurte une surface, il en génère d'autres : rayons d'ombre vers chaque source de lumière, rayons de réflexion, rayons de réfraction. En path tracing, ce chiffre explose avec de multiples rebonds indirects par pixel. Faisons le calcul brut :
8,3 millions de rayons multipliés par 30 millions de triangles géométriques. Cela donne environ 250 000 milliards de tests d'intersection rayon-triangle par frame. À 60 images par seconde, le processeur graphique devrait exécuter 15 millions de milliards d'opérations géométriques chaque seconde. C'est tout simplement impossible. Aucun circuit de silicium grand public n'a cette bande passante ni cette puissance de calcul brute. En complexité algorithmique, nous sommes face à un cauchemar en O(N) : plus la scène contient d'objets, plus le temps de calcul s'écroule de manière linéaire et violente.
La mécanique interne du bvh : arborescences et boîtes englobantes
Pour esquiver cette impasse, l'industrie graphique s'appuie sur une structure d'accélération spatiale : le BVH (Bounding Volume Hierarchy). L'idée fondamentale est d'une simplicité désarmante, même si son exécution matérielle relève de l'orfèvrerie.
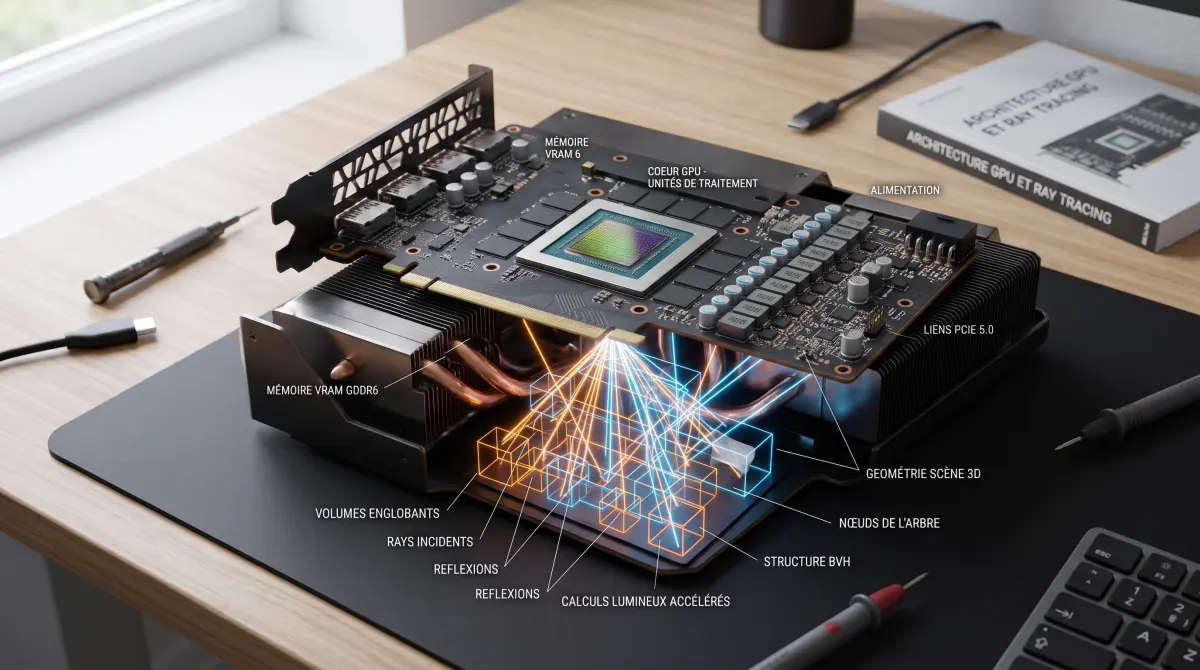
Au lieu de tester si un rayon touche directement un polygone microscopique situé au fin fond d'une pièce, le moteur englobe des groupes d'objets dans des boîtes virtuelles appelées AABB (Axis-Aligned Bounding Boxes). Ces parallélépipèdes rectangles restent alignés sur les axes X, Y et Z du repère 3D, ce qui rend le test d'intersection avec une droite mathématiquement trivial : quelques opérations arithmétiques de base suffisent.
L'arbre BVH s'organise de manière hiérarchique :
- Le nœud racine : Une immense boîte englobant l'intégralité de la scène 3D visible.
- Les nœuds internes : Chaque boîte se divise en deux boîtes plus petites (arbre binaire), qui contiennent des sous-ensembles d'objets de plus en plus restreints.
- Les feuilles : Au bout des branches se trouvent les boîtes ultimes, qui ne contiennent plus qu'une poignée de triangles géométriques réels.
Désormais, quand un rayon est projeté par le moteur de rendu, il teste d'abord la boîte racine. S'il ne la touche pas ? Le calcul s'arrête là, rejetant 100 % des polygones de la scène d'un seul coup. S'il la touche, il descend vers les deux boîtes enfants. S'il rate la boîte de gauche, toute cette branche est instantanément ignorée. Grâce à ce découpage, la complexité passe d'un catastrophique O(N) à un très élégant O(log N). Au lieu de tester 30 millions de polygones, le GPU n'exécute que quelques dizaines de tests de boîtes puis deux ou trois intersections de triangles finaux. Le ray tracing gpu passe du fantasme de laboratoire au temps réel.
Tlas et blas : comment le moteur gère les mondes en mouvement
Construire un arbre BVH demande un temps de calcul lourd. Dans un film d'animation chez Pixar, générer ces structures hors ligne ne pose aucun problème. Mais dans un jeu d'action où des dizaines de bolides foncent, où des ennemis courent et où les décors s'effondrent, les triangles bougent à chaque milliseconde. Si le GPU devait recalculer l'intégralité du BVH à chaque frame, les performances s'effondreraient aussitôt.
Pour contourner ce verrou, les API graphiques modernes comme Vulkan Ray Tracing et DirectX 12 DXR divisent la structure en deux étages distincts :
D'un côté, le BLAS (Bottom-Level Acceleration Structure). Il stocke la géométrie locale propre à chaque modèle 3D (votre personnage, une voiture, un réverbère). Tant que l'objet ne se déforme pas, son BLAS ne change jamais. Le GPU le calcule une bonne fois pour toutes et le garde bien au chaud en mémoire VRAM.
De l'autre côté, le TLAS (Top-Level Acceleration Structure). C'est l'arbre supérieur, qui ne contient pas de triangles mais de simples pointeurs vers les BLAS, associés à leurs matrices de transformation spatiale (position, rotation, échelle). Quand une bagnole roule dans le champ de vision, le GPU n'a pas besoin de recalculer ses milliers de polygones : il modifie simplement ses coordonnées dans le TLAS. Ce recalcul rapide — souvent appelé rebuild ou refit — prend moins d'une demi-milliseconde sur le processeur graphique.
| Composant / Concept | BLAS (Bottom-Level) | TLAS (Top-Level) |
|---|---|---|
| Contenu stocké | Sommets, arêtes et triangles réels du mesh | Instances d'objets, matrices de transformation, flags |
| Fréquence de mise à jour | Statique (recalculé uniquement si déformation de maillage) | Dynamique (reconstruit ou adapté à chaque frame) |
| Empreinte VRAM | Élevée (dépend directement du nombre de polygones) | Faible (quelques mégaoctets pour des milliers d'instances) |
| Rôle algorithmique | Intersection finale rayon-triangle (feuilles de l'arbre) | Traversée spatiale globale dans la scène 3D |
Matériel dédié : rt cores chez NVIDIA contre ray accelerators chez AMD
Comprendre la théorie algorithmique est une chose, mais voir comment le silicium traite le problème en est une autre. Pendant des années, les cartes graphiques traitaient ces calculs via leurs unités de calcul génériques (les Shaders). Le résultat était médiocre.
Tout a basculé en 2018 quand Nvidia a introduit l'architecture Turing et ses fameux RT Cores. C'est un bloc de silicium fixe, un ASIC dédié à l'intérieur du GPU qui ne sait faire que deux choses, mais qui les fait à une vitesse terrifiante :
- La traversée des nœuds du BVH (tester si le rayon coupe une boîte AABB).
- Le test d'intersection rayon-triangle quand une feuille de l'arbre est atteinte.
Sur l'architecture Ada Lovelace (RTX séries 40) documentée en détail par NVIDIA Developer, les RT Cores de 3e génération intègrent même des moteurs matériels pour réordonner l'exécution des calculs (Shader Execution Reordering) et gérer le positionnement des boîtes face à des géométries transparentes ou changeantes (Opacity Micromap et Displaced Micro-Mesh). Pendant que le RT Core parcourt le BVH de manière autonome, les cœurs de calcul classiques (les SM) restent entièrement libres pour exécuter la physique, l'échantillonnage de textures et la post-production.
Chez AMD, l'approche retenue sur les architectures RDNA 2 et RDNA 3 est différente. Les rouges ont choisi d'intégrer un Ray Accelerator au sein de chaque Compute Unit. Ce composant accélère le test d'intersection géométrique, mais partage une bonne partie des registres et des caches de données de texture avec les shaders conventionnels. La traversée pure du BVH retombe souvent sous la responsabilité d'instructions vectorielles classiques. Résultat ? Dès que la densité du BVH grimpe en flèche ou que le nombre de rayons par pixel s'emballe, les cartes Radeon accusent un déficit de performances bien plus marqué que leurs homologues GeForce. Ce n'est pas une question d'optimisation logicielle bâclée par les développeurs : c'est un choix fondamental d'architecture matérielle.
Du ray tracing hybride au path tracing intégral : le saut d'échelle
Pendant les cinq premières années du ray tracing en temps réel, les studios de développement ont joué la prudence avec un modèle hybride : la rastérisation traditionnelle continuait de peindre l'image principale, tandis que le GPU ne tirait des rayons que pour des tâches ciblées (les reflets spéculaires dans les vitres, les ombres de contact ou l'occlusion ambiante). Dans ce contexte, l'arbre BVH était sollicité de manière modérée.
Avec l'arrivée du Path Tracing (ou lancer de chemin complet) dans des titres vitrines comme Alan Wake 2, le paradigme change radicalement. La rastérisation est mise à la poubelle. Chaque pixel de votre moniteur devient l'origine de multiples trajectoires de photons simulées qui rebondissent de surface en surface pour capturer l'éclairage indirect global.
Pour le BVH, la charge de travail ne se contente pas de doubler : elle devient hautement divergente. Les rayons primaires partent tous de la caméra dans une direction relativement cohérente, ce qui permet aux caches L2 des GPU de mutualiser les accès aux boîtes englobantes. En revanche, après deux ou trois rebonds sur des surfaces rugueuses, les rayons secondaires partent dans des directions totalement chaotiques. Ils frappent des pans entiers et disparates de l'arbre BVH. C'est l'effondrement du cache (cache miss), la VRAM est bombardée de requêtes non alignées, et le pipeline graphique frôle l'engorgement.
C'est exactement là que se joue l'avenir du hardware gaming. Les futures générations de puces graphiques ne chercheront plus seulement à ajouter des téraflops bruts. Elles se battront sur leur capacité à compacter la structure du BVH en mémoire locale, à réduire le coût énergétique de la traversée de boîtes englobantes et à réordonner les flux de rayons désordonnés avant qu'ils ne touchent les cœurs de calcul.