Vous ne pouvez plus ouvrir la moindre fiche technique d'ordinateur portable sans vous faire matraquer par un acronyme : le TOPS. Les départements marketing d'Intel, AMD, Qualcomm et Apple ont trouvé leur nouveau terrain de jeu pour remplacer la course aux mégahertz des années 2000. Désormais, si votre machine n'affiche pas au moins 40 TOPS au compteur pour coller aux exigences de Microsoft Copilot+, elle appartiendrait presque à l'âge de pierre. Soyons clairs : on assiste à un enfumage en règle.
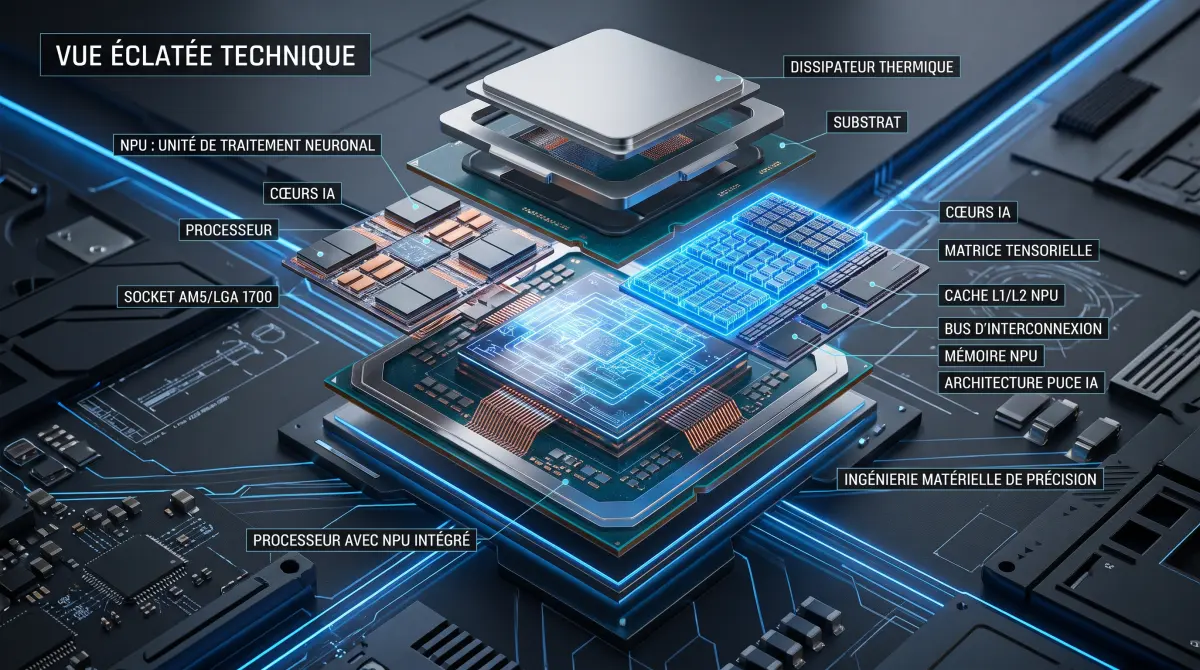
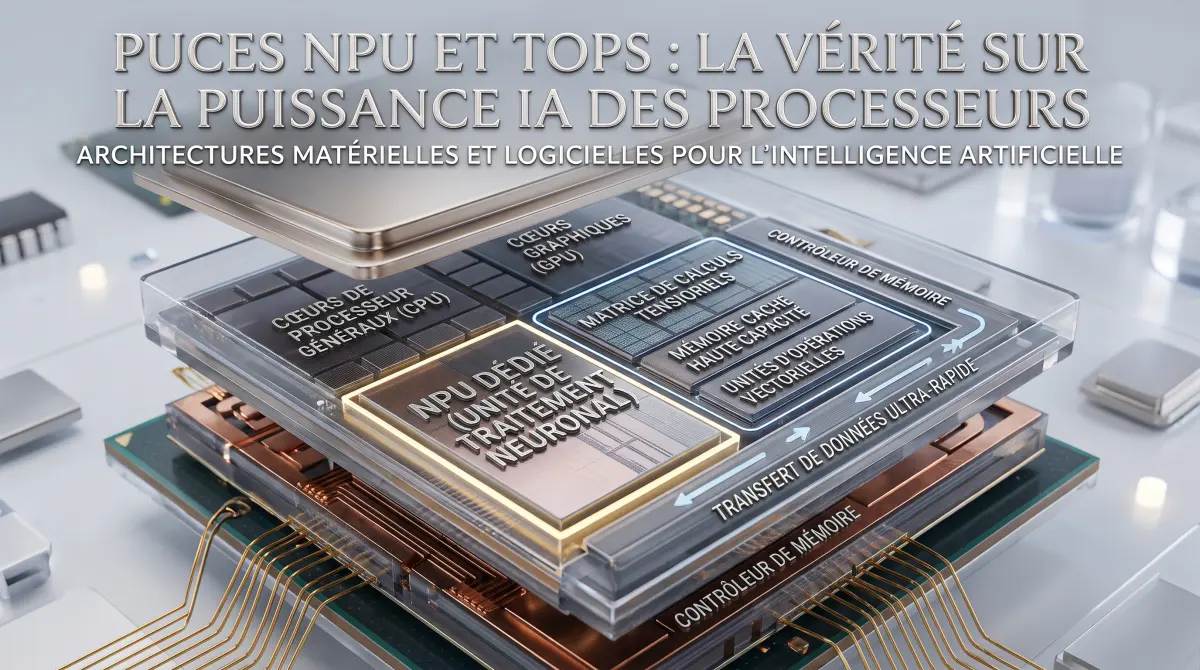
Sur mon établi de test, je vois défiler ces architectures depuis des mois. Quand je décortique les entrailles d'un Snapdragon X Elite, d'un Core Ultra Lunar Lake ou d'un Ryzen AI Strix Point, la réalité des benchmarks démonte l'argumentaire simpliste des constructeurs. Un NPU (Neural Processing Unit) n'est pas une baguette magique. Cette unité de traitement neuronal obéit à des lois physiques très strictes où le silicium, la hiérarchie mémoire et l'optimisation logicielle pèsent bien plus lourd qu'un vulgaire chiffre gravé sur un slide PowerPoint.
L'illusion des tops : anatomie d'une métrique taillée pour les plaquettes commerciales
Que mesure exactement cette valeur ? TOPS signifie Tera Operations Per Second, soit mille milliards d'opérations exécutées en une seconde (1012). Présenté ainsi, le chiffre donne le vertige. Sauf que personne dans l'industrie ne précise spontanément la nature exacte de ces opérations. Dans le monde des puces NPU TOPS, l'unité de calcul élémentaire est l'opération MAC (Multiply-Accumulate), qui consiste à multiplier deux nombres puis à ajouter le produit à un accumulateur : a = a + (b * c). Une opération MAC compte mathématiquement pour deux opérations distinctes.
Pour calculer le score théorique qu'arbore fièrement un fabricant, la formule s'avère basique :
TOPS = (Nombre d'unités MAC × 2 × Fréquence d'horloge en GHz) / 1000Si un bloc neuronal intègre 2 048 unités MAC et tourne à 1,2 GHz, son calcul théorique donne tout juste 4,9 TOPS. Pour atteindre les 45 ou 50 TOPS réclamés par les ordinateurs portables de dernière génération, les fondeurs multiplient les réseaux de calculs systoliques ultra-spécialisés. Mais ce chiffre représente un pic théorique absolu. C'est l'équivalent de faire tourner le moteur de ma Tesla sur un banc d'essai sans roues et sans résistance de l'air : amusant sur le papier, inutile sur l'autoroute.
Pire encore : certains acteurs n'hésitent pas à cumuler les capacités du CPU, du GPU intégré et du NPU pour afficher un prétendu « score de plateforme » de 80 ou 100 TOPS. C'est malhonnête. Faire tourner une charge d'inférence continue sur un GPU mobile fait exploser le TDP à 45 watts et vide votre batterie en une heure et demie. L'intérêt exclusif d'un NPU réside dans son ratio performance par watt, capable d'engloutir ces matrices avec une enveloppe thermique contenue entre 2 et 8 watts.
Int8, fp16 ou int4 : quand les constructeurs bricolent la précision des calculs
Voici le secret le moins bien gardé des fabricants : les TOPS n'ont aucun sens si on ne précise pas le format de données sous-jacent. Historiquement, l'entraînement et l'inférence des réseaux de neurones s'effectuaient en virgule flottante sur 32 bits (FP32), voire 16 bits (FP16). Problème ? Ces calculs complexes réclament énormément de transistors, chauffent et drainent les accumulateurs.
Pour faire exploser les scores tout en limitant la consommation, l'industrie s'est massivement rabattue sur la quantification en entiers 8 bits (INT8). Le principe consiste à compresser les poids du modèle mathématique pour les faire tenir sur des nombres entiers courts. Résultat direct : on divise par deux la taille mémoire et on double instantanément le débit des opérations par rapport au FP16. Lorsque Qualcomm annonce 45 TOPS sur son Hexagon ou qu'Intel avance 48 TOPS sur son NPU 4, ils parlent exclusivement d'opérations INT8.
Certains vont plus loin dans la surenchère en intégrant des accélérateurs taillés pour l'INT4 (entiers sur 4 bits). Mathématiquement, vous doublez encore les TOPS sans changer la fréquence ! Pourtant, appliquer une quantification INT4 agressive sur un grand modèle de langage (LLM) détruit souvent sa précision et augmente la perplexité des réponses générées. Vous obtenez un processeur ultra-rapide qui raconte n'importe quoi avec aplomb. Pour approfondir les subtilités de ces formats matriciels, la documentation de l'environnement ONNX Runtime détaille parfaitement l'impact de la quantification sur les débits d'exécution réels.
Le vrai goulot d'étranglement : pourquoi la bande passante mémoire dicte tout
Pourquoi votre machine à 45 TOPS peine-t-elle à cracher 15 tokens par seconde sur un modèle de langage local ? Parce que le processeur passe son temps à attendre. C'est ce qu'on appelle dans le jargon hardware le mur de la mémoire (memory wall).
Décortiquons le processus d'un LLM comme Llama-3-8B quantifié en 4 bits. Pour générer un seul token — un mot ou un bout de mot —, le processeur doit charger l'intégralité des poids du réseau depuis la mémoire vive vers ses registres. Pour un modèle 8B en 4 bits, cela représente environ 4,5 à 5 Go de données par token ! Si votre PC portable dispose d'un contrôleur LPDDR5X à double canal culminant péniblement à 100 Go/s de bande passante effective, divisez simplement :
Débit maximal théorique = 100 Go/s / 5 Go = 20 tokens/secondeVotre NPU pourrait disposer de 200 TOPS qu'il ne tournerait pas un iota plus vite. Ses milliers d'unités de calcul restent inoccupées 80 % du temps, affamées de données. C'est pour cette exacte raison qu'Apple domine insolemment l'inférence locale sur ses puces haut de gamme. Le Neural Engine d'une puce Apple M4 plafonne à 38 TOPS — ce qui est inférieur sur le papier aux concurrents x86 —, mais la mémoire unifiée des variantes Pro et Max arrose le silicium à plus de 270 ou 540 Go/s. Voilà où réside la vraie puissance matérielle.
Snapdragon x elite, lunar lake, strix point et Apple m4 : le banc d'essai comparatif
Mettons les mains dans le cambouis. Pour y voir clair, j'ai compilé les métriques techniques réelles des quatre grandes familles de silicium qui se disputent le marché des processeurs nomades récents. On constate immédiatement le gouffre entre le chiffre brut et l'architecture sous-jacente.
| SoC / Processeur | Architecture NPU | Puissance NPU (INT8) | Type de mémoire | Bande passante mémoire | Gravure |
|---|---|---|---|---|---|
| Qualcomm Snapdragon X Elite (X1E-80-100) | Hexagon NPU | 45 TOPS | LPDDR5X-8448 (128 bits) | 135 Go/s | TSMC 4 nm (N4P) |
| Intel Core Ultra 7 258V (Lunar Lake) | NPU 4.0 (6 matrices) | 47 TOPS | LPDDR5X-8533 (sur package) | 136,5 Go/s | TSMC 3 nm (N3B) |
| AMD Ryzen AI 9 HX 370 (Strix Point) | XDNA 2 | 50 TOPS (Block FP16) | LPDDR5X-7500 / DDR5 | Jusqu'à 120 Go/s | TSMC 4 nm (N4P) |
| Apple M4 (10 cœurs) | Apple Neural Engine (16 cœurs) | 38 TOPS | LPDDR5X (128 bits unifié) | 120 Go/s | TSMC 3 nm (N3E) |
Remarquez la particularité d'AMD avec son architecture XDNA 2. Au lieu de se borner à l'INT8 basique, la firme de Santa Clara exploite un format propriétaire baptisé Block FP16. L'idée est astucieuse : conserver la précision dynamique du FP16 en regroupant les exposants tout en utilisant des chemins de données de type INT8 pour maintenir un débit théorique de 50 TOPS. Sur mes tests de transcription audio avec Whisper et de vision par ordinateur, cette approche évite les artefacts de quantification sans effondrer la consommation électrique.
De son côté, Intel a corrigé le tir avec Lunar Lake. La première génération Meteor Lake plafonnait à 11,5 TOPS, ce qui était ridicule face aux besoins de l'OS. Avec NPU 4.0 et ses 47 TOPS gravés en 3 nm chez TSMC, Intel revient dans la course de plain-pied, tout en déportant la mémoire LPDDR5X directement sur le substrat de la puce pour raboter les latences.
L'enfer des frameworks logiciels : directml, openvino, core ml et le mirage multiplateforme
Avoir du bon silicium ne sert strictement à rien si le logiciel est incapable de lui adresser des instructions. Et c'est là que le bât blesse sévèrement aujourd'hui. L'écosystème PC x86 et ARM subit une fragmentation effroyable.
Pour faire exécuter un modèle par votre NPU sous Windows, le développeur doit passer par des API intermédiaires. Microsoft pousse son framework Windows AI Platform avec DirectML, censé uniformiser l'accès aux accélérateurs matériels. Dans la pratique ? C'est le jour et la nuit selon le matériel sous-jacent :
- Qualcomm QNN : Le kit de développement Qualcomm Neural Processing Engine est très véloce, mais il impose des conversions de modèles spécifiques souvent pénibles pour les développeurs indépendants.
- Intel OpenVINO : L'outil d'Intel est le plus mature du monde x86. Il optimise remarquablement bien les réseaux de neurones pour le NPU et l'iGPU, mais reste principalement orienté vers le matériel de la marque.
- AMD ROCm et XDNA drivers : AMD progresse, mais le support grand public pour intégrer directement des modèles PyTorch ou Hugging Face sur leurs NPU sous Windows reste en chantier permanent comparé à leur offre serveur.
- Apple Core ML : À l'inverse du monde Windows, Apple contrôle la chaîne de A à Z. N'importe quel modèle converti en Core ML s'exécute nativement et instantanément sur le Neural Engine sans que l'utilisateur n'ait à paramétrer la moindre variable d'environnement.
Tant que ces couches logicielles ne seront pas stabilisées, votre NPU passera le plus clair de son temps à faire tourner des tâches mineures : flouter votre arrière-plan sous Teams, générer trois stickers dans Paint ou appliquer un filtre de réduction de bruit sur votre micro. Un luxe très cher payé pour du silicium dédié.
Faut-il vraiment acheter un PC portable pour son NPU aujourd'hui ?
Posons les pieds sur terre. Si vous achetez une machine en 2026 uniquement en scrutant son nombre de TOPS, vous faites fausse route. Cette statistique rappelle furieusement les mégapixels des capteurs photo de smartphones d'il y a dix ans : un chiffre facile à afficher sur une boîte, qui ne garantit en rien la qualité finale de l'image.
Les NPU sont indispensables pour l'avenir de nos machines nomades, c'est indiscutable. Décharger le CPU et la carte graphique des calculs d'inférence répétitifs permet de préserver l'autonomie et d'éviter que le châssis ne se transforme en grille-pain. Mais leur efficacité dépend à 10 % des TOPS théoriques, à 40 % de la bande passante mémoire et à 50 % du bon vouloir des développeurs qui adapteront ou non leurs bibliothèques logicielles.
Mon conseil technique ? Regardez d'abord la quantité globale de mémoire vive (16 Go devient un strict minimum, 32 Go est recommandé dès qu'on touche à l'IA locale), intéressez-vous au débit de cette RAM en Go/s, puis vérifiez la compatibilité des logiciels que vous utilisez quotidiennement. Le badge 40, 45 ou 50 TOPS finira par s'effacer bien avant que l'industrie n'ait réussi à exploiter la moitié de ce que ces accélérateurs ont réellement dans le ventre.