On entend tout et n'importe quoi sur le ray tracing depuis que Nvidia a dégainé ses premières GeForce RTX en 2018. Certains continuent d'y voir un filtre visuel pompeux inventé pour vendre des GPU à 1500 euros, d'autres le défendent aveuglément sans piger ce qui tourne réellement sous le capot. La réalité technique, moi, je la mesure chaque semaine sur mes bancs de test : calculer la lumière physique en temps réel est un non-sens algorithmique total. Si l'on s'amusait à tester brutalement chaque rayon sur chaque polygone d'une scène moderne, même une RTX 5090 cracherait péniblement une trame par heure.
Pourquoi ? Parce qu'un monde de jeu vidéo actuel ne compte pas trois cailloux qui se battent en duel. Sur Alan Wake 2 ou Cyberpunk 2077, vous affichez couramment 30 à 60 millions de triangles par vue. Ajoutez à cela un tir de millions de rayons par seconde pour les ombres, les réflexions et les rebonds indirects. Multipliez les deux grandeurs. Vous obtenez des quintillions d'intersections à vérifier à chaque soixantième de seconde. Autant essayer de vider l'océan avec une passoire.
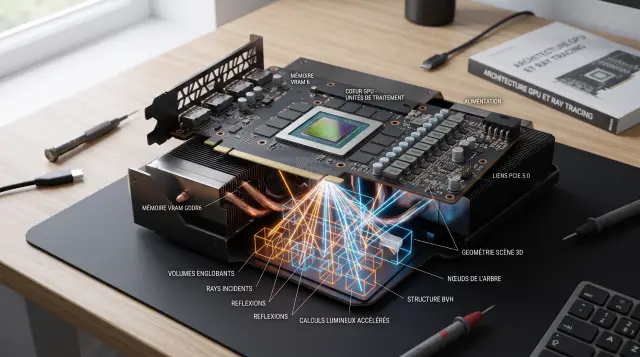
Pour contourner ce mur mathématique, les ingénieurs hardware et logiciel n'avaient qu'une arme : élaguer massivement l'espace géométrique. C'est là qu'entre en scène le BVH (Bounding Volume Hierarchy). Sans cette structure algorithmique, le ray tracing en temps réel n'existerait tout simplement pas.
Du lancer de rayons au path tracing : le cauchemar de la force brute
Mettons d'abord les pendules à l'heure sur le plan sémantique. Le terme parapluie « ray tracing » masque des approches radicalement disparates. Pendant des décennies, le jeu vidéo a régné par la rastérisation : une méthode astucieuse consistant à projeter des polygones 3D sur un écran 2D plat, puis à simuler la lumière à coup de textures précalculées, de shadow maps approximatives et d'astuces d'ombres portées dans l'espace écran (SSAO). C'est ultra-rapide, mais c'est faux dès qu'un objet sort du champ de vision.
Le ray tracing hybride a débarqué pour combler ces trous. Le moteur rastérise la scène pour la majorité des pixels, mais lance des rayons ciblés pour corriger les ombres de contact ou refléter des surfaces métalliques. C'est propre, bien que limité à un ou deux rebonds lumineux simples. Le path tracing va infiniment plus loin. Ici, oubliez la rastérisation des éclairages : on simule l'intégralité du transport radiométrique via des méthodes de Monte-Carlo. On projette des rayons depuis la caméra, qui ricocheront d'un mur à une table, traverseront une vitre, capteront la teinte d'un tapis rouge pour teinter le plafond, avant de mourir sur une source lumineuse. C'est splendide. C'est aussi un carnage computationnel.
Prenez un rendu 4K standard (3840 × 2160 pixels). Cela représente 8,3 millions de points d'impact au départ. Si votre moteur lance seulement 2 rayons primaires par pixel, puis 3 rebonds par rayon secondaire, vous devez tracer des dizaines de millions de vecteurs lumineux à chaque trame. En force brute, tester mathématiquement chaque rayon contre chaque polygone de la scène présente une complexité de O(N × M), où N représente les rayons et M les triangles. Même gravée en 3 nanomètres avec des téraflops à revendre, aucune puce au silicium ne peut encaisser un tel volume de calculs d'intersections directes.
Qu’est-ce que le bvh et pourquoi sauve-t-il nos fréquences d’images ?
C'est ici qu'intervient la structure d'accélération indispensable : le Bounding Volume Hierarchy. Le principe fondamental ? Ranger toute la géométrie de votre jeu dans un arbre hiérarchique de boîtes englobantes, plus précisément des AABB (Axis-Aligned Bounding Boxes). Ces boîtes rectangulaires sont alignées rigoureusement sur les axes X, Y et Z de la scène 3D, ce qui rend le calcul d'intersection d'un rayon avec leurs faces trivial pour un processeur.
Imaginez que vous cherchiez un mot précis dans une bibliothèque municipale contenant des millions de pages. La force brute consisterait à entrer dans le bâtiment, à ouvrir le tout premier livre sur la gauche, à le lire mot à mot, puis à passer au deuxième livre, et ainsi de suite jusqu'au dernier rayon du fond. Vous y passeriez votre existence. Le BVH, lui, fonctionne comme un archiviste méthodique :
- La boîte racine : elle englobe la ville ou le niveau entier. Si votre rayon lumineux vise vers le ciel sans toucher cette énorme boîte, le test s'arrête net. Zéro triangle testé.
- Les branches : la boîte racine se divise en sous-boîtes représentant par exemple des pièces, des rues ou des véhicules. Si le rayon touche une sous-boîte, le GPU traverse l'arbre pour voir quelles branches intérieures sont concernées.
- Les feuilles (leaves) : tout en bas de la pyramide se trouvent les plus petites boîtes, ne contenant qu'une poignée de triangles (souvent 1 à 4). Le GPU n'effectue le calcul d'intersection précis (algorithme de Möller-Trumbore) que sur ces quelques polygones finaux.
Grâce à cette approche arborescente, la complexité mathématique s'effondre de O(N) à O(log N). Au lieu de tester 10 millions de polygones un par un, mon GPU ne réalise qu'une vingtaine de vérifications boîte-rayon successives avant de dénicher le triangle percuté. C'est cette division colossale de l'effort de recherche qui permet aux cartes graphiques d'afficher des images au lieu d'un diaporama figé.
Tlas et blas : comment le moteur gère le décor et les monstres qui bougent
Dans un jeu vidéo, la géométrie n'est pas statique. Les décors en béton ne bougent pas, mais votre personnage court, recharge son arme, tandis que des véhicules explosent au loin. Construire un arbre BVH coûteux pour 50 millions de polygones à chaque milliseconde mettrait le processeur à genoux. Les développeurs et les API graphiques comme Vulkan ou DirectX 12 ont donc divisé le problème en deux étages étanches : le TLAS et le BLAS, comme le détaille la documentation de la spécification Vulkan Ray Tracing de Khronos Group.
Le BLAS (Bottom-Level Acceleration Structure) représente la géométrie locale d'un objet précis : une bagnole, une table, un monstre. Les triangles de cet élément y sont emboîtés une bonne fois pour toutes dans leur propre mini-arbre BVH. Si l'objet est rigide (un lampadaire, un fusil), le GPU calcule son BLAS une seule fois au chargement du niveau et le conserve en mémoire VRAM sans jamais y retoucher.
Le TLAS (Top-Level Acceleration Structure), au contraire, est une vue d'ensemble macroscopique. Il ne contient aucun triangle direct. Il se contente de référencer des « instances » de BLAS placées dans l'espace mondial du jeu via des matrices de transformation (position, rotation, échelle). Quand une berline traverse une rue à pleine vitesse, le moteur graphique ne recalcule pas son maillage interne ; il met simplement à jour sa position dans le TLAS. Reconstruire ou réajuster (« refit ») un TLAS ne prend qu'une fraction de milliseconde, permettant aux scènes dynamiques de rester fluides sans réécrire l'arbre géométrique complet.
Au cœur du silicium : les architectures GPU face au calcul de volume
Une structure de données élégante sur le papier ne sert à rien si vous la confiez à une unité de calcul inadaptée. Historiquement, un GPU excelle dans les calculs vectoriels massivement parallèles (SIMD/SIMT). Vous lui donnez 10 000 pixels à teinter avec les mêmes opérations mathématiques, il le fait sans ciller. Mais la traversée d'un arbre BVH est l'exact opposé : c'est un algorithme bourré de branchements conditionnels, de sauts de pointeurs mémoire et d'accès aléatoires en cache.
Si vous faites exécuter la traversée d'un arbre BVH par les shaders traditionnels (les SM chez Nvidia ou les CU chez AMD), vous provoquez ce que l'on appelle de la divergence d'exécution. Au sein d'un même groupe de threads (warp ou wave), certains rayons touchent une boîte et doivent descendre plus profondément dans l'arbre, tandis que d'autres ratent la cible et s'arrêtent. Les cœurs de calcul classiques se retrouvent alors désynchronisés, contraints d'attendre les threads les plus lents. Résultat : une perte d'efficacité dramatique.
C'est précisément la raison pour laquelle Nvidia a introduit les RT Cores dès l'architecture Turing. Ces blocs matériels dédiés sont des circuits en silicium taillés sur mesure pour décharger les shaders de deux tâches chronophages : le test boîte-rayon (Box Intersection) et le test triangle-rayon (Triangle Intersection). Les shaders normaux émettent une requête de rayon via une instruction spécifique, puis retournent travailler sur d'autres tâches graphiques pendant que le bloc matériel parcourt le BVH en mémoire cache L1/L2 dédiée, comme l'explique le document de référence NVIDIA RTX Ray Tracing Architecture.
| Constructeur / Architecture | Unité matérielle dédiée | Traitement du Box Traversal (BVH) | Calcul Ray-Triangle | Poids sur les unités de shader |
|---|---|---|---|---|
| Nvidia (Turing, Ampere, Ada Lovelace) | RT Core (1re, 2e et 3e génération) | Matériel 100% dédié (circuits câblés asynchrones) | Matériel dédié (BVH traversal + ray-tri intersection) | Nul pendant la recherche : les SM sont totalement libérés |
| AMD (RDNA 2, RDNA 3) | Ray Accelerator (RA) | Partagé : filtrage de textures et calculs mixtes | Matériel semi-dédié intégré aux Compute Units | Moyen à lourd : forte dépendance envers les pipelines vectoriels |
| Intel (Arc Alchemist, Battlemage) | Ray Tracing Unit (RTU) | Matériel 100% dédié (double pipeline de traversée) | Matériel dédié (tests d'impact boîtes et maillages) | Faible : désynchronisation matérielle similaire à Nvidia |
Ce tableau résume parfaitement l'écart de performance constaté sur le terrain. Pourquoi les cartes Radeon se font-elles laminer dès que l'on active le path tracing intégral dans un jeu ? Parce que leur approche matérielle dans RDNA 2 et RDNA 3 partage trop de ressources physiques avec le pipeline de texture standard. Dès que le nombre de rebonds explose, la traversée du BVH monopolise la bande passante et étouffe les unités de calcul. Chez Nvidia et dans une moindre mesure chez Intel, le hardware dédié gère la traversée de manière autonome sans cannibaliser les calculs de tramage standards.
Le coût caché : pourquoi le path tracing s’appuie toujours sur des béquilles
Aussi brillant soit-il, le BVH ne résout pas la totalité de l'équation. Même optimisée, la descente d'arbre engendre une latence de lecture mémoire non négligeable. Lorsque des millions de rayons secondaires rebondissent dans tous les sens de manière totalement incohérente (un rayon part vers le sol, l'autre vers le ciel), la hiérarchie de mémoire cache du GPU sature. On appelle cela le divergent memory access.
C'est pourquoi aucun jeu vidéo moderne ne tourne en path tracing « pur ». Pour sortir du 60 images par seconde en haute résolution, les moteurs doivent tricher méthodiquement :
- L'échantillonnage ultra-faible : le moteur ne tire qu'un ou deux rayons par pixel (souvent moins de 1 ray per pixel en lumière diffuse), produisant une image brute ressemblant à une bouillie de grains de sel et de poivre.
- Le débruitage spatial et temporel (Denoiser) : des algorithmes complexes comparent les trames précédentes et mélangent les données pour combler les trous de lumière sans flouter les arêtes géométriques.
- Le Shader Execution Reordering (SER) : introduit par Nvidia sur les puces Ada Lovelace (RTX série 40), ce procédé réorganise dynamiquement à la volée les rayons éparpillés pour regrouper ceux qui tapent dans la même boîte BVH, rétablissant une cohérence d'exécution dans le silicium.
- L'upscaling algorithmique : sans DLSS, FSR ou XeSS pour rendre la scène en 1080p ou 1440p avant d'interpoler l'image finale en 4K, le path tracing mettrait même un monstre de 450 watts à genoux.
La lumière par lancer de rayons a quitté le domaine théorique des laboratoires de recherche pour s'installer dans nos salons. Mais gardez toujours en tête que derrière chaque flaque d'eau brillante et chaque ombre douce réaliste dans vos jeux vidéo préférés, il n'y a rien d'autre qu'un algorithme d'arbre binaire bête, méchant et rigoureusement optimisé pour éviter à votre carte graphique de calculer le néant.