Quand j'entends certains développeurs affirmer que Linux et Windows « font globalement la même chose sous le capot », j'avoue avoir des sueurs froides. C'est faux. Fondamentalement faux. Si l'utilisateur moyen ne voit qu'une interface graphique avec des fenêtres rectangulaires et un navigateur web, le monde qui s'agite sous l'espace utilisateur (le userland) répond à deux philosophies techniques diamétralement opposées.
D'un côté, nous avons le géant open source né sur un coin de table à Helsinki en 1991, devenu le moteur de 90 % du cloud mondial et de nos supercalculateurs. De l'autre, l'architecture NT (New Technology), pensée par le mythique Dave Cutler à la fin des années 1980 après son départ de DEC, devenue la base inébranlable de toutes les déclinaisons de Windows depuis Windows 2000 jusqu'à nos versions modernes de Windows 11 et Windows Server. J'ai passé des années à monitorer des clusters Linux en production et à débugger des pannes sur des serveurs Windows. Pour trancher le match noyau Linux Windows, il faut aller farfouiller là où ça fait mal : dans les allocations mémoire, les files d'attente des threads et les mécanismes d'isolation système.
Monolithique modulaire contre architecture hybride : deux visions irréconciliables
La première fracture saute aux yeux dès qu'on décompile ou qu'on cartographie l'espace d'adressage du noyau :
- Linux est un noyau monolithique modulaire : la totalité des services fondamentaux — ordonnanceur, gestionnaire de mémoire virtuelle, pilotes de périphériques, piles réseau, systèmes de fichiers — s'exécute dans le même espace mémoire privilégié (Ring 0 sur x86-64). Pas d'intermédiaire. Si un pilote doit parler au planificateur de tâches, l'accès se fait par un simple appel de fonction interne en mémoire vive, sans changement de contexte matériel coûteux. Les modules (les fichiers
.ko) se chargent et se déchargent dynamiquement au runtime, mais ils intègrent physiquement le même espace d'exécution. C'est redoutablement rapide. Le risque ? Un driver mal torché fait tomber la machine avec un kernel panic. - Windows NT est un noyau hybride : Cutler voulait au départ un micronoyau pur, inspiré de Mach, où chaque service tourne dans son propre processus isolé. Problème : dans les années 1990, les commutations de contexte (le fameux context switching) tuaient littéralement les performances graphiques et I/O. Microsoft a donc fait machine arrière. Le noyau de base (le microkernel
ntoskrnl.exe) reste minimaliste et gère le bas niveau (interruptions, threads élémentaires). Autour de lui gravite l'Executive (I/O Manager, Security Reference Monitor, Virtual Memory Manager) qui tourne aussi en Ring 0. Mais une énorme partie des sous-systèmes applicatifs, des sessions et de la compatibilité historique repose sur des couches intermédiaires comme la HAL (Hardware Abstraction Layer) et le sous-système Win32 (dont des pans ont été réintégrés au Ring 0 viawin32k.syspour des impératifs d'affichage).
Résultat concret sur le banc de test : Linux fait le choix de l'efficacité brute avec un coût d'appel système minimal. Windows privilégie une abstraction modulaire plus stricte, quitte à traîner une surcharge CPU mesurable lors des passages fréquents entre mode utilisateur et mode noyau.
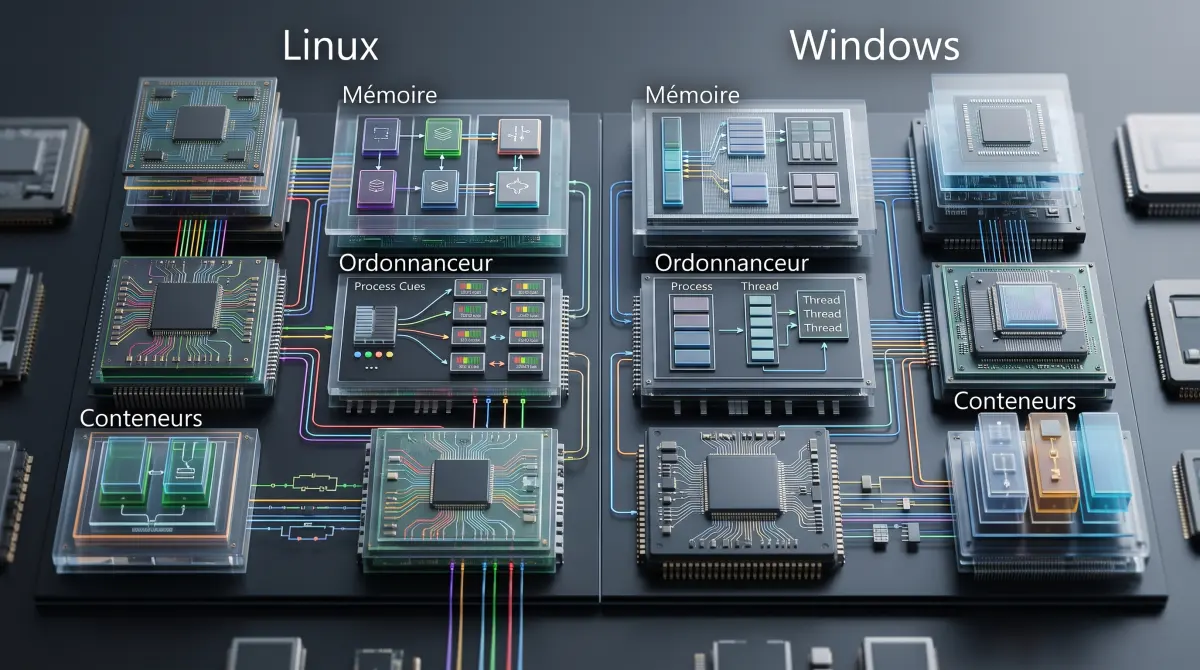
Gestion de la mémoire : l'overcommit sans pitié face aux working sets calibrés
C'est sans doute le domaine où le fossé technique est le plus violent. Linux et Windows ne conçoivent pas du tout la mémoire vive (RAM) de la même manière.
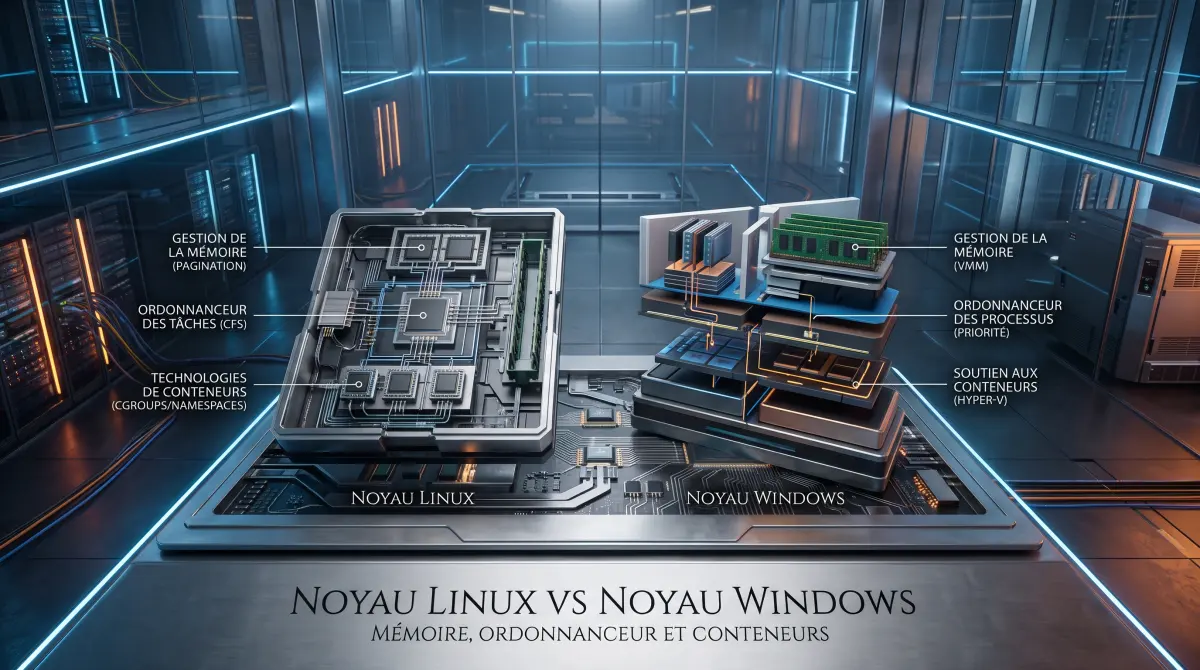
Sur Linux, la règle par défaut s'appelle l'overcommit. Quand un processus sollicite de la mémoire via malloc() ou l'appel système mmap(), le noyau Linux répond immédiatement par l'affirmative et lui attribue de l'espace d'adressage virtuel. Mais aucune page physique de RAM n'est allouée à cet instant précis. Linux fait un pari : il parie que l'application ne va pas utiliser immédiatement les gigaoctets réclamés. Tant que les pages ne sont pas écrites (génération d'un page fault mineur), la RAM physique reste libre pour le cache de fichiers (le fameux page cache unifié).
Que se passe-t-il si toutes les applications réclament leur dû en même temps et que la RAM sature ? C'est le bain de sang. L'OOM Killer (Out Of Memory Killer) se réveille, calcule un score d'indésirabilité pour chaque processus en fonction de sa taille et de son paramètre oom_score_adj, puis zigouille sauvagement le coupable pour sauver le système d'exploitation. Pour les administrateurs de bases de données, ce comportement est souvent une hantise, au point qu'on règle souvent le sysctl vm.overcommit_memory = 2 pour forcer un refus strict des allocations non couvertes.
Windows adopte une posture radicalement conservatrice. Il n'existe aucun overcommit sous Windows NT. Si une application demande 16 Go de mémoire validée (commit), le gestionnaire de mémoire virtuelle (VMM) de Windows s'assure impérativement que cette allocation peut être adossée soit à la RAM physique, soit au fichier d'échange (pagefile.sys). Si la somme RAM + Pagefile est atteinte (la Commit Limit), l'allocation échoue net avec une erreur STATUS_COMMITMENT_LIMIT. Pas d'OOM Killer chez Microsoft. Vos programmes plantent proprement en renvoyant une erreur d'allocation, mais le système refuse de jouer à la roulette russe.
Pour réguler la pression mémoire, Windows utilise le concept de Working Set (jeu de travail) : chaque processus se voit assigner un quota de pages physiques minimum et maximum. Quand la mémoire globale vient à manquer, le thread système Balance Set Manager vient rogner les pages inactives des processus pour les balancer dans la Modified Page List ou la Standby List. L'allocation de bas niveau est séparée entre le Paged Pool (mémoire noyau swappable sur disque) et le Non-Paged Pool (réservée strictement en RAM pour les structures critiques d'I/O et les pilotes). C'est beaucoup plus prévisible pour un logiciel bureautique lourd, mais moins souple pour densifier des conteneurs à l'extrême sur un serveur.
Ordonnancement des threads : le saut vers eevdf face aux priorités de Windows
Comment l'OS décide-t-il quel thread s'exécute sur vos 16 cœurs et 32 threads à la milliseconde près ? Là encore, les visions s'affrontent.
Pendant plus de quinze ans, Linux s'est appuyé sur le CFS (Completely Fair Scheduler), imaginé par Ingo Molnar. Le principe reposait sur un arbre binaire rouge-noir (Red-Black Tree) traquant le temps d'exécution virtuel (vruntime) de chaque tâche pour garantir une équité parfaite. Mais le CFS montrait ses limites sur la latence d'activation des threads temps réel légers. Depuis la sortie du noyau Linux 6.6 fin 2023, le mainteneur Peter Zijlstra a fait adopter EEVDF (Earliest Eligible Virtual Deadline First), documenté en détail sur la documentation officielle du noyau Linux. EEVDF ne se contente plus de viser l'équité temporelle brute : il associe à chaque thread un délai d'éligibilité et une deadline virtuelle. Les tâches qui ont peu consommé de CPU passent en priorité absolue avec une latence quasi-nulle, ce qui métamorphose la réactivité des interfaces graphiques et le rendu audio sans sacrifier le débit des gros calculs batch.
Chez Windows, le scheduler de ntoskrnl.exe est un ordonnanceur préemptif basé sur des niveaux de priorité stricts, gradués de 0 à 31 :
- Les niveaux 16 à 31 sont réservés au temps réel (non préemptibles par les applications standard).
- Les niveaux 1 à 15 accueillent les threads variables normaux.
- Le niveau 0 est dédié au thread Zero Page qui nettoie la RAM en arrière-plan.
Windows utilise un système de tranches de temps (quantum) et de bonus dynamiques (priority boosting). Si vous cliquez sur une fenêtre qui n'avait plus le focus, le noyau lui colle temporairement un coup de boost de priorité pour qu'elle réponde immédiatement au clic. Idem lors de la sortie d'une attente d'entrée/sortie (I/O). C'est ce qui donne à Windows cette impression d'immédiateté sur le bureau graphique.
Il faut toutefois rendre justice aux ingénieurs de Redmond sur un point : leur intégration du matériel récent est remarquable. Grâce à l'étroite collaboration avec Intel sur le Thread Director, le scheduler de Windows 11 gère remarquablement bien les architectures hybrides (cœurs P performants et cœurs E basse consommation sur Alder Lake, Raptor Lake et Arrow Lake). Le scheduler de Windows sait exactement router les threads d'arrière-plan vers les cœurs basse consommation pour laisser les cœurs véloces aux tâches de premier plan. Linux comble l'écart via les patches ITMT et le framework sched_ext, mais l'intégration de Windows dans cet écosystème PC grand public reste d'une efficacité chirurgicale.
Isolation des conteneurs : l’élégance native contre le détour par l’hyperviseur
C'est ici que le match tourne à la démonstration technique en faveur du monde libre. Tout le monde utilise Docker et Kubernetes aujourd'hui. Mais savez-vous ce qu'est réellement un conteneur ?
Sous Linux, un conteneur n'est absolument pas une machine virtuelle. C'est simplement un processus standard qui tourne sur le noyau de l'hôte, mais bridé et isolé par deux fonctionnalités intégrées nativement au kernel :
- Les Namespaces (espaces de noms) : ils compartimentent ce que le processus a le droit de *voir*. Le namespace PID lui fait croire qu'il est le processus 1 (init), le namespace NET lui fournit sa propre table de routage et ses interfaces réseau virtuelles, tandis que les namespaces MNT, IPC, USER et UTS verrouillent le reste.
- Les Cgroups (Control Groups, v1 et v2) : ils restreignent ce que le processus a le droit de *consommer*. On bride le CPU, la RAM physique, le swap et les I/O disque à l'octet près.
Cette approche est d'une élégance absolue. Démarrer un conteneur Linux prend quelques millisecondes, car le noyau hôte instancie juste une structure de données sans créer de couche de virtualisation intermédiaire.
Sur Windows, l'histoire est un calvaire architectural. Le noyau NT n'a jamais été pensé à l'origine pour empiler des espaces de noms décorrélés du système d'exploitation global. Microsoft a bien développé les Windows Server Containers en créant des abstractions (les Job Objects évolués et les silos de serveurs), mais le registre Windows, les services RPC et les dépendances du sous-système Win32 rendent l'isolation complète extrêmement instable sans isoler le système en profondeur.
Pour pallier cette faiblesse, Microsoft s'appuie massivement sur les Hyper-V Containers. Comme l'explique la documentation officielle de Microsoft Learn sur les conteneurs Windows, chaque conteneur s'exécute en réalité à l'intérieur d'une micro-machine virtuelle extrêmement allégée, avec son propre noyau Windows dédié et son hyperviseur Hyper-V de type 1. C'est sécurisé, certes, mais la pénalité sur l'empreinte mémoire, le stockage et le temps de démarrage est colossale comparée à la légèreté d'un conteneur Linux natif.
Tableau comparatif : les entrailles des deux systèmes face à face
| Caractéristique technique | Noyau Linux (branche moderne 6.x) | Noyau Windows NT (10.0.x / 11 / Server) |
|---|---|---|
| Architecture générale | Monolithique modulaire (tout le kernel en Ring 0) | Hybride (micro-noyau étendu + Executive + HAL) |
| Stratégie de mémoire virtuelle | Overcommit par défaut (optimiste) + OOM Killer | Commit Charge strict (pessimiste, aucun overcommit) |
| Cache de disque et de fichiers | Page Cache unifié intégré dynamiquement à la RAM libre | Working Sets dynamiques + Standby / Modified Lists |
| Planificateur de tâches principal | EEVDF (remplaçant du Completely Fair Scheduler) | Préemptif basé sur 32 priorités + Priority Boosting |
| Gestion des cœurs hybrides (P/E cores) | Sched_ext, topologies ACPI / ITMT (en amélioration) | Support natif avancé via Intel Thread Director |
| Technologie d'isolation conteneur | Natif : Namespaces (PID, NET, MNT...) + Cgroups v2 | Silos NT (rare) ou micro-VMs isolées via Hyper-V |
| Appels système (Syscalls) | Interface stable directe (numéros de syscalls figés) | Interface indirecte (non documentée, via ntdll.dll / Win32) |
Ce que ce duel architectural change sur vos machines
Alors, qui gagne ? Poser la question en ces termes est stérile. Ce qu'il faut analyser, c'est l'adéquation entre le design du code et l'usage final de la machine.
Le noyau Linux a été dépouillé de tout artifice commercial. Son interface de syscalls est figée dans le marbre : Linus Torvalds refuse catégoriquement qu'une mise à jour du noyau casse l'espace utilisateur (« Never break userspace »). Cette stabilité absolue des primitives système, combinée au modèle Cgroups/Namespaces, en fait la plateforme serveur ultime. C'est grâce à cette architecture que vous pouvez faire tourner des milliers de microservices sur un seul serveur bare-metal sans effondrer le planificateur de tâches.
Windows NT, à l'inverse, protège ses syscalls derrière une barrière opaque : les développeurs ne s'adressent jamais directement au noyau, ils passent par les API de haut niveau de kernel32.dll, user32.dll ou ntdll.dll. Microsoft conserve ainsi la mainmise sur son écosystème tout en maintenant une rétrocompatibilité logicielle ahurissante — je peux encore faire tourner sur Windows 11 un utilitaire compilé pour Windows 95 il y a trente ans. Son scheduler sait exactement comment donner du confort à un joueur qui lance un titre AAA tout en discutant sur Discord et en streamant sur Twitch.
Comprendre ces mécanismes évite de commettre de lourdes erreurs de dimensionnement. La prochaine fois que votre conteneur Docker refusera de démarrer ou que votre serveur s'arrêtera pour cause d'OOM Killer, vous saurez exactement quel composant du Ring 0 a pris la décision d'exécuter la sentence.