Ras le bol d'envoyer vos données chez OpenAI ou d'attendre le bon vouloir des serveurs d'Anthropic ? Je vous comprends. L'exécution d'un modèle de langage en local est devenue un réflexe pour tout bidouilleur soucieux de sa vie privée ou développeur voulant coder hors ligne dans le train. Sur le papier, la promesse d'un outil comme le dépôt GitHub d'Ollama est déconcertante : une commande dans le terminal, et vous voilà avec un clone de ChatGPT sous le capot. Magique ? Pas si vite.
Dès qu'on pousse un peu la machine, la réalité matérielle vous rattrape au tournant. Votre carte graphique se met à hurler, le modèle se traîne à trois tokens par seconde et le système commence à swapper comme à l'époque de Windows Vista. Exécuter un LLM avec ollama local n'a rien d'un jeu vidéo classique : ici, la puissance brute de calcul (les TFLOPS) passe au second plan. Ce qui commande tout, c'est la mémoire. Sa taille, sa vitesse et la façon dont vous découpez vos modèles.
Pourquoi la VRAM dicte impitoyablement vos performances
Soyons clairs : si votre modèle ne tient pas intégralement dans la VRAM de votre carte graphique, vous êtes mort. Enfin, pas mort au sens propre, mais votre expérience utilisateur va agoniser.
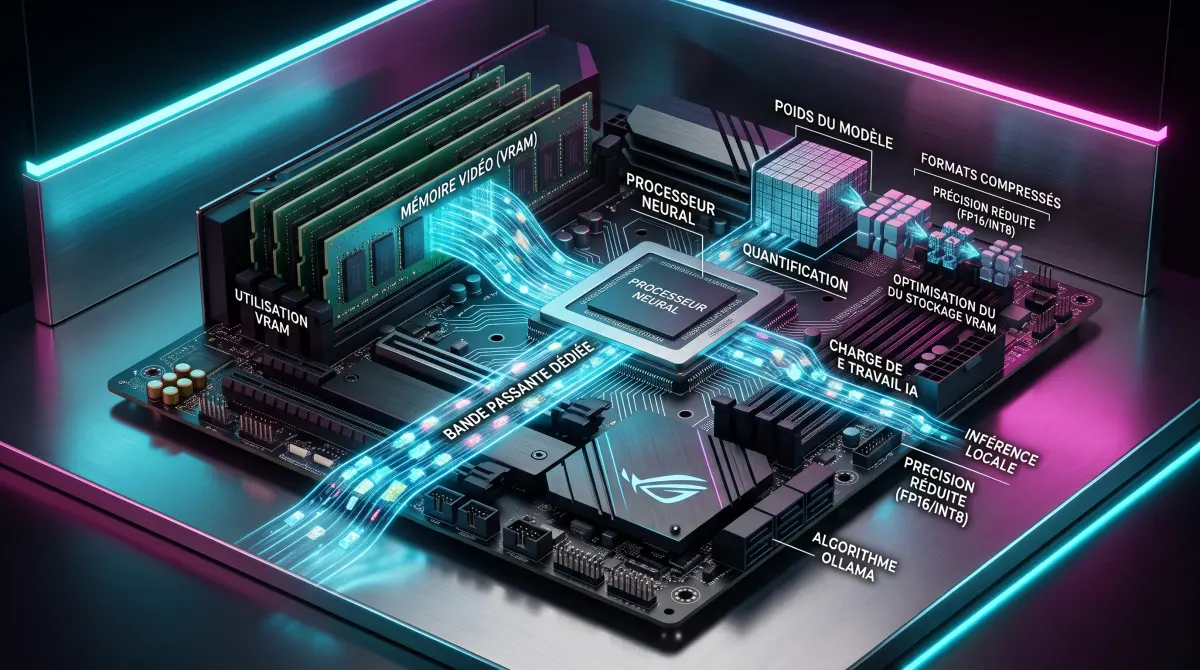
Pourquoi ? Parce qu'Ollama s'appuie sous le capot sur le projet open-source llama.cpp. Quand une couche de réseau de neurones ne rentre pas dans les puces de votre GPU, le moteur décharge le surplus sur votre mémoire vive système (la RAM du PC) via le bus PCIe. C'est ce qu'on appelle l'offloading partiel. Sur ma machine de test équipée d'une RTX 4090, si je charge un modèle de 70 milliards de paramètres qui déborde de quelques gigaoctets sur ma DDR5, mon débit s'effondre de 18 tokens par seconde à péniblement 1,8 token par seconde. Une division par dix. Inutilisable.
La VRAM est une mémoire soudée ultra-rapide connectée directement au processeur graphique par un bus large (jusqu'à 384 bits sur une 4090). Votre RAM centrale, elle, transite par les pistes de la carte mère sur un bus ridicule de 128 bits. Tenter de faire de l'inférence en jonglant entre les deux revient à vider une piscine olympique avec une paille.
Bande passante mémoire : le vrai secret du débit de tokens
On nous rabat les oreilles avec les cœurs CUDA ou les TFLOPS en précision FP16. Du pur marketing pour ce cas d'usage précis. L'inférence d'un LLM en phase de génération autoregressive (quand le modèle recrache les mots un par un) ne sature presque jamais les unités de calcul arithmétique. Elle sature la bande passante mémoire.
Pour générer un misérable token, le GPU doit lire l'intégralité des poids du modèle stockés en mémoire. Vous avez bien lu : TOUS les poids. Si votre modèle pèse 16 Go et que votre carte graphique dispose d'une bande passante théorique de 500 Go/s, votre vitesse de génération maximale théorique ne pourra jamais dépasser 31 tokens par seconde (500 divisé par 16). Rien à faire des milliers de cœurs graphiques qui dorment à côté : ils attendent simplement que les données arrivent du bus mémoire.
Regardons le matériel sans langue de bois :
- RTX 3060 12 Go : 360 Go/s de bande passante. La championne du budget. C'est lent sur les gros modèles, mais ses 12 Go de VRAM permettent de faire tourner des modèles de 8 milliards de paramètres sans déborder.
- RTX 4060 Ti 16 Go : 288 Go/s de bande passante. Une honte absolue sur le plan de l'architecture avec son bus étriqué de 128 bits. Elle a de la mémoire, oui, mais le goulot d'étranglement ralentit cruellement la cadence.
- RTX 4070 Ti Super 16 Go : 672 Go/s. Là, on commence à respirer grâce à son bus 256 bits.
- RTX 4090 24 Go : 1008 Go/s. Le monstre grand public indiscutable.
- Apple Silicon (M2/M3/M4 Max ou Ultra) : L'architecture unifiée d'Apple change la donne. Avec 300 à 800 Go/s de bande passante partagée et jusqu'à 128 ou 192 Go de RAM accessibles au GPU sans passer par un bus PCIe, c'est aujourd'hui la seule alternative viable aux cartes professionnelles hors de prix pour faire tourner des monstres de 70B en local.
Quantization gguf : comprendre le compromis entre poids et perplexité
Puisque la VRAM est rare et chère, les ingénieurs ont trouvé la parade : la quantization (ou quantification pour les puristes). À l'entraînement, les modèles utilisent des nombres flottants sur 16 bits (FP16), voire 32 bits. Un modèle de 8 milliards de paramètres en FP16 pèse environ 16 Go. Trop lourd pour la majorité des GPU du marché.
La quantization consiste à arrondir ces poids mathématiques pour les stocker sur 8 bits, 5 bits, 4 bits ou même 2 bits. Dans l'écosystème Ollama, tout tourne autour du format GGUF. Quand vous tapez ollama run llama3.1, vous téléchargez par défaut une version quantifiée en 4 bits nommée Q4_K_M.
Quel impact sur l'intelligence du modèle ? On mesure cette perte de précision via la "perplexité" (plus le chiffre est bas, plus le modèle est fidèle à l'original) :
- Q8_0 (8 bits) : Dégradation mathématique imperceptible. Poids divisé par deux par rapport au FP16 natif. Très lourd, réservé à ceux qui ont de la mémoire à revendre.
- Q5_K_M (5 bits) : Le juste milieu absolu selon mes bancs d'essai. La dégradation logique reste marginale, le raisonnement ne vacille pas, et on gagne une place précieuse.
- Q4_K_M (4 bits) : Le standard de l'industrie pour le grand public. Excellente rétention globale, même si on observe quelques hallucinations supplémentaires sur du code très pointu ou de la logique formelle.
- Q2_K ou Q3_K (2 ou 3 bits) : À fuir sauf curiosité technique. Le modèle commence à bégayer, oublie les consignes système et sort des absurdités. Évitez de massacrer un bon modèle juste pour le faire rentrer au forceps dans une vieille carte.
Calculer la mémoire réelle : modèle, contexte et kv cache
Voici l'erreur classique du débutant : regarder la taille du fichier GGUF téléchargé et penser que cela suffit pour évaluer la VRAM requise. Vous téléchargez un modèle de 4,7 Go, vous avez une carte graphique de 6 Go, vous lancez Ollama et... plantage ou ralentissement brutal.
Pourquoi ? Parce qu'il faut intégrer le KV cache (Key-Value cache).
Quand vous discutez avec le modèle, celui-ci doit garder en mémoire vive l'historique complet de votre session d'échange. Plus la fenêtre de contexte augmente (2 048 tokens, 8 192 tokens, ou les 128 000 tokens permis par Llama 3.1), plus ce cache mémoire enfle de manière exponentielle. Avec un contexte poussé à 32k tokens sur un modèle moyen, le KV cache peut facilement réclamer entre 2 et 4 Go de VRAM supplémentaire rien que pour lui !
La formule brute pour anticiper votre consommation mémoire ressemble à ceci :
VRAM Requise = Taille_Poids_Quantifiés + KV_Cache(taille_contexte) + Overhead_CUDA (~500 Mo)
Si la somme dépasse la capacité physique de votre GPU, les couches restantes basculent vers la RAM système. Et votre débit s'effondre.
Tableau comparatif des besoins matériels par gabarit de modèle
J'ai compilé ci-dessous les chiffres réels observés sur mes configurations d'essai pour vous éviter les mauvaises surprises avant de lancer un téléchargement de plusieurs dizaines de gigaoctets.
| Gabarit du modèle | Quantization | Poids disque / VRAM modèle | VRAM min. recommandée (contexte 8k) | GPU grand public cible | Vitesse moyenne observée |
|---|---|---|---|---|---|
| Small (1.5B à 3B) Qwen 2.5 / Llama 3.2 |
Q4_K_M / Q8_0 | 1,8 à 3,2 Go | 6 Go | RTX 3050, 2060, GTX 1660 Ti | 60 à 90 tok/s |
| Standard (7B à 9B) Llama 3.1 8B, Mistral 7B |
Q4_K_M | 4,9 Go | 8 à 10 Go | RTX 3060 12 Go, RTX 4060 8 Go* | 35 à 45 tok/s (sur 12 Go) |
| Standard (7B à 9B) Llama 3.1 8B, Mistral 7B |
Q8_0 | 8,5 Go | 12 Go | RTX 3060 12 Go, RTX 4070 12 Go | 25 à 35 tok/s |
| Intermédiaire (14B) Qwen 2.5 14B |
Q4_K_M | 9,0 Go | 14 Go | RTX 4060 Ti 16 Go, RTX 4070 Ti Super | 20 à 30 tok/s |
| Lourd (32B à 34B) Qwen 2.5 32B |
Q4_K_M | 19,8 Go | 24 Go | RTX 3090, RTX 4090 (24 Go) | 18 à 24 tok/s |
| Très lourd (70B) Llama 3.3 70B |
Q4_K_M | 42,5 Go | 48 Go (Multi-GPU ou Mac) | 2x RTX 3090 / Mac Studio M2 Ultra | 12 à 18 tok/s |
*Attention à la RTX 4060 8 Go : le modèle 8B tient tout juste, mais un contexte large saturera la mémoire instantanément.
Optimiser ollama au millimètre sur Linux et Windows
Sous Windows, par pitié, oubliez l'environnement WSL2 si votre machine est un peu juste techniquement. Ollama propose désormais un binaire natif Windows qui gère directement les pilotes NVIDIA sans surcouche de virtualisation superflue. Sur ma machine de bureau, le binaire natif m'a fait gagner près de 1,2 Go de mémoire vidéo que WSL2 réservait bêtement au sous-système Linux.
Deuxième point névralgique : la gestion de la fenêtre de contexte par défaut. Par précaution, Ollama configure souvent un contexte minuscule (souvent 2 048 tokens). Si vous lui balancez un PDF complet de 50 pages à analyser, il va tronquer le document sans vous prévenir. Pour augmenter le contexte proprement dans un fichier Modelfile :
FROM llama3.1:8b-instruct-q5_K_M
PARAMETER num_ctx 16384
PARAMETER temperature 0.7
Puis compilez votre instance locale via le terminal :
ollama create mon-llama-16k -f ./ModelfileSurveillez l'allocation en temps réel avec la commande nvidia-smi sous Linux/Windows ou l'utilitaire asitop sur macOS. Si vous constatez que le GPU ne prend que 90% des couches du modèle et délègue le reste au processeur central, réduisez légèrement le paramètre num_ctx. Il vaut cent fois mieux un contexte de 8 000 tokens exécuté à 40 tokens/seconde à 100% dans la VRAM, qu'un contexte mirifique de 32 000 tokens qui fait plonger l'ensemble de votre machine à 2 tokens/seconde.
L'exécution locale n'est pas une question de puissance brute, mais une équation d'équilibre entre la largeur de vos bus mémoire et la rigueur de vos quantizations. Réglez vos contextes selon vos vrais besoins, surveillez vos allocations à l'octet près, et vous profiterez d'un environnement ultra-rapide, gratuit et totalement hermétique aux curieux.